전체 모습을 참조하면 원치 않는 가방, 액세서리, 양말, 신발 등을 AI 가상 착용에 포함할 수 있습니다. 이 테스트를 거친 프롬프트는 대상 의류, 보존된 세부 정보 및 명시적 제외 항목을 구분합니다.
아래 두 이미지는 동일한 모델 사진과 동일한 의상 참고 자료를 바탕으로 제작되었습니다. 지시 사항만 달랐습니다.
빠른 답변
AI 모델의 가상 착용 이미지에 어떤 요소가 포함될지 제어하려면, 요청을 네 가지 계층으로 구성하세요. 대상 의류, 참조 이미지의 역할, 보존 규칙, 그리고 제외 항목입니다. 모델 사진은 신원과 포즈를 나타내고, 의류 사진은 의류의 구조를 나타냅니다. 제외해야 할 모든 액세서리나 추가 레이어는 명확하게 명시하세요.
"이 옷을 이 모델에게 입히세요"라는 지시사항이 불충분한 이유는 무엇일까요?
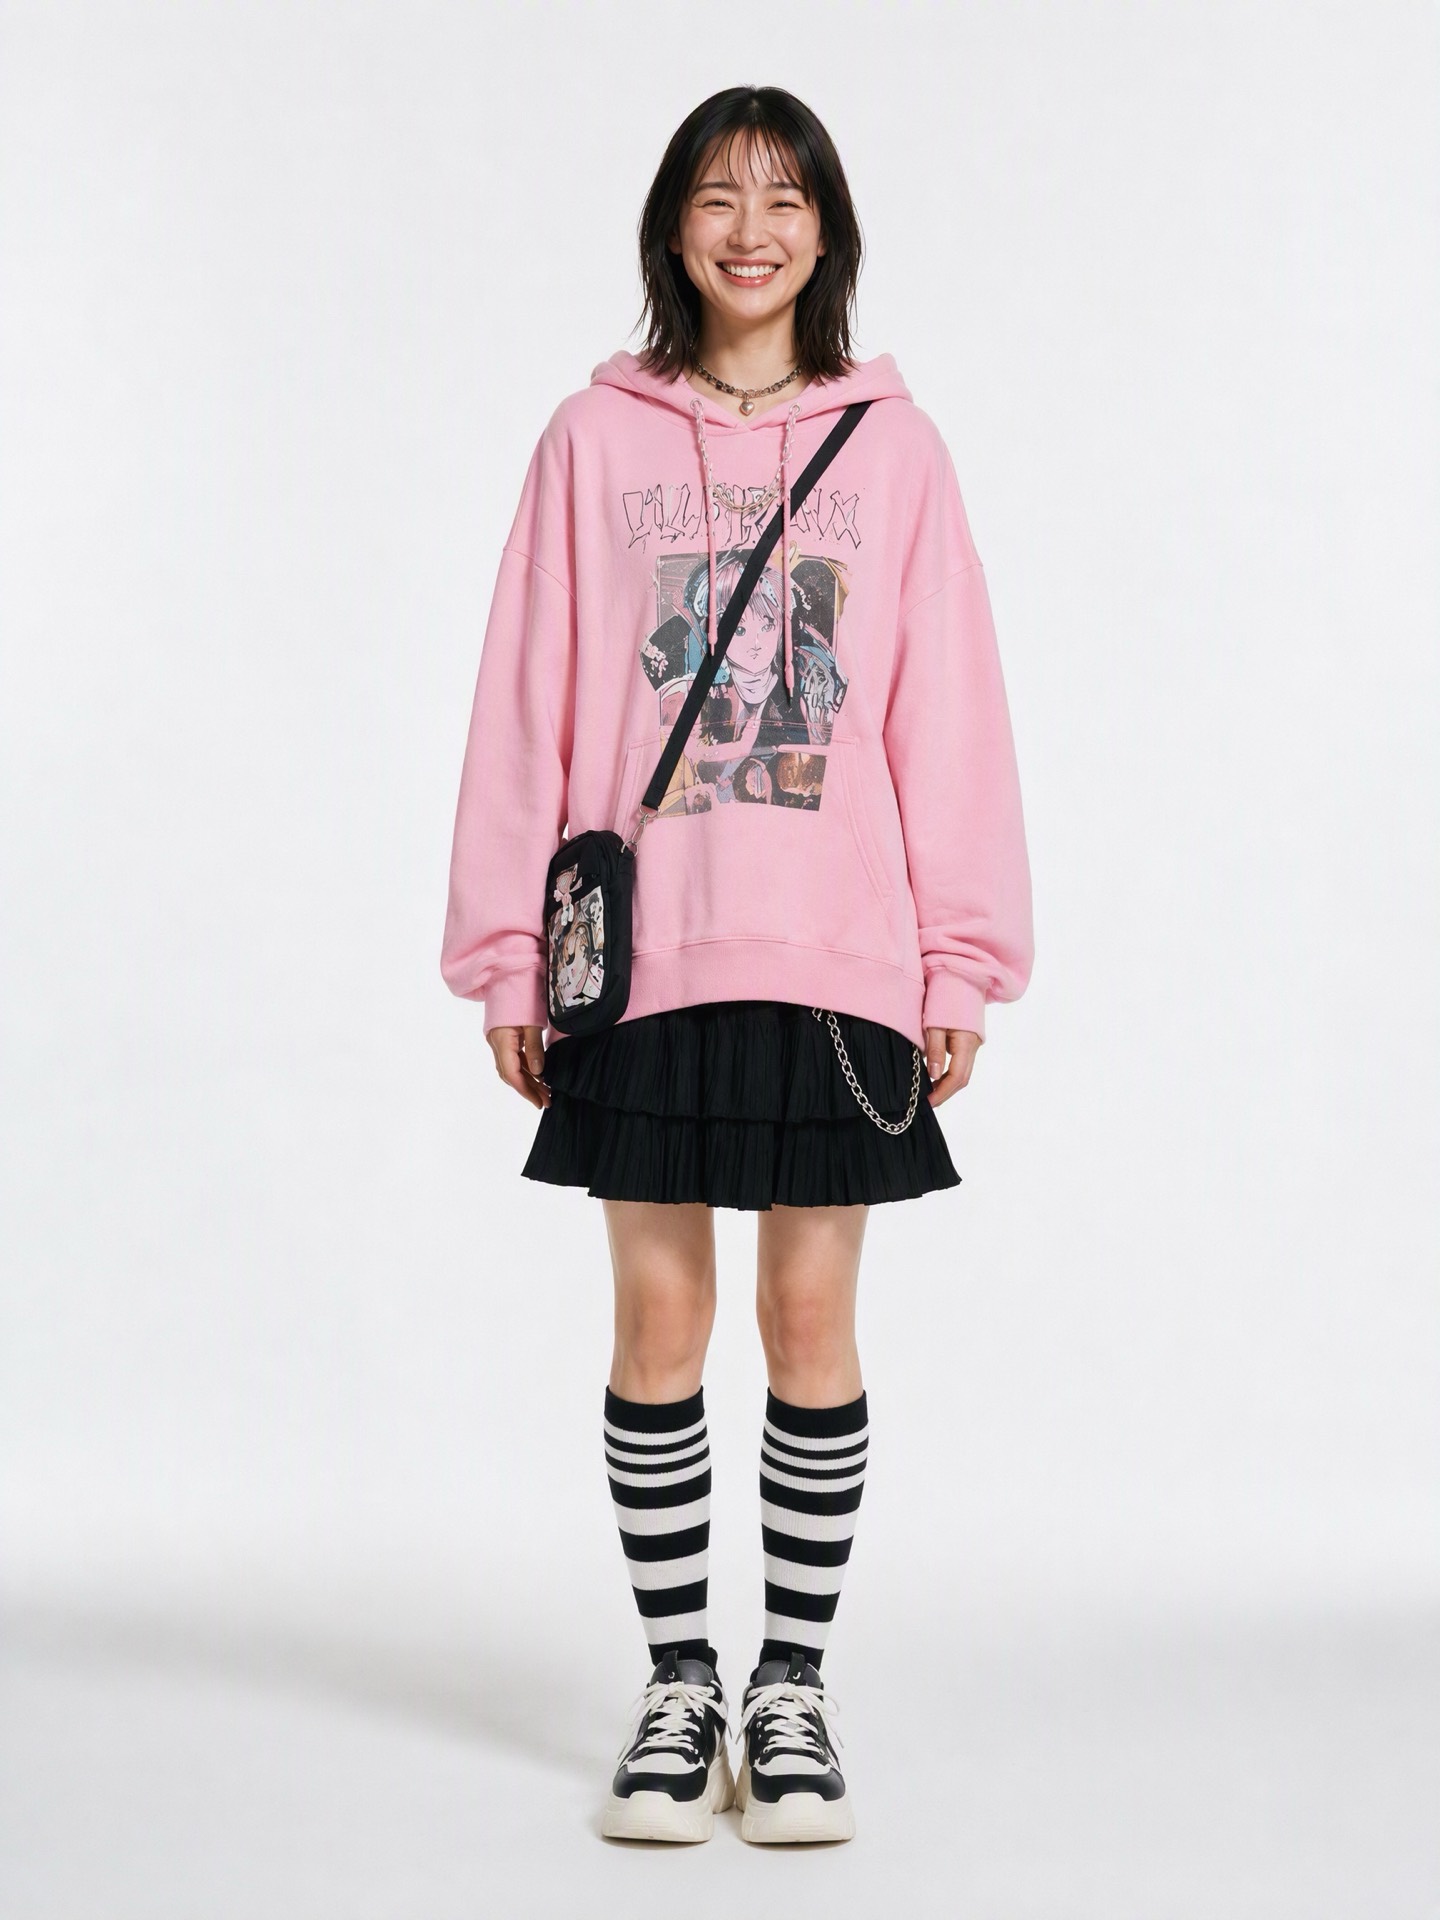
전체적인 스타일을 구상하는 데에는 수많은 결정 사항이 따릅니다. 저희가 참고한 의상 이미지에는 핑크색 그래픽 후드티, 여러 겹으로 된 검은색 스커트, 크로스백, 레이어드 목걸이, 스커트 체인, 줄무늬 양말, 플랫폼 스니커즈, 귀걸이, 그리고 다른 헤어스타일이 포함되어 있었습니다.
"이미지 2의 옷을 이미지 1의 모델에게 입히세요"라는 간단한 요청에는 어떤 요소가 중요한지 명시되어 있지 않았습니다. 생성된 결과는 전체적인 모습을 그대로 복사했습니다. 시각적으로는 일관성이 있었지만, 실제 목표가 후드티와 치마뿐이었다면 이는 잘못된 결과였습니다.
그 차이는 중요합니다. 보기 좋은 이미지라도 제품의 목적을 달성하지 못할 수 있습니다.
전체적인 모습이 아닌 평면 사진이나 옷걸이 사진으로 시작하는 경우라면, 저희가 제시하는 보다 포괄적인 워크플로우부터 시작해 보세요. 옷 사진을 이용해 AI 모델 착용 이미지 생성. 의류 사진 자체에 보정이 필요한 경우, 보정 방법을 참조하세요. 모델 없이 옷 사진을 찍으세요 생성하기 전에.
각 참조 이미지에 한 가지 작업을 부여하세요.
이 두 가지 입력값이 두 테스트 모두에 사용되었습니다.
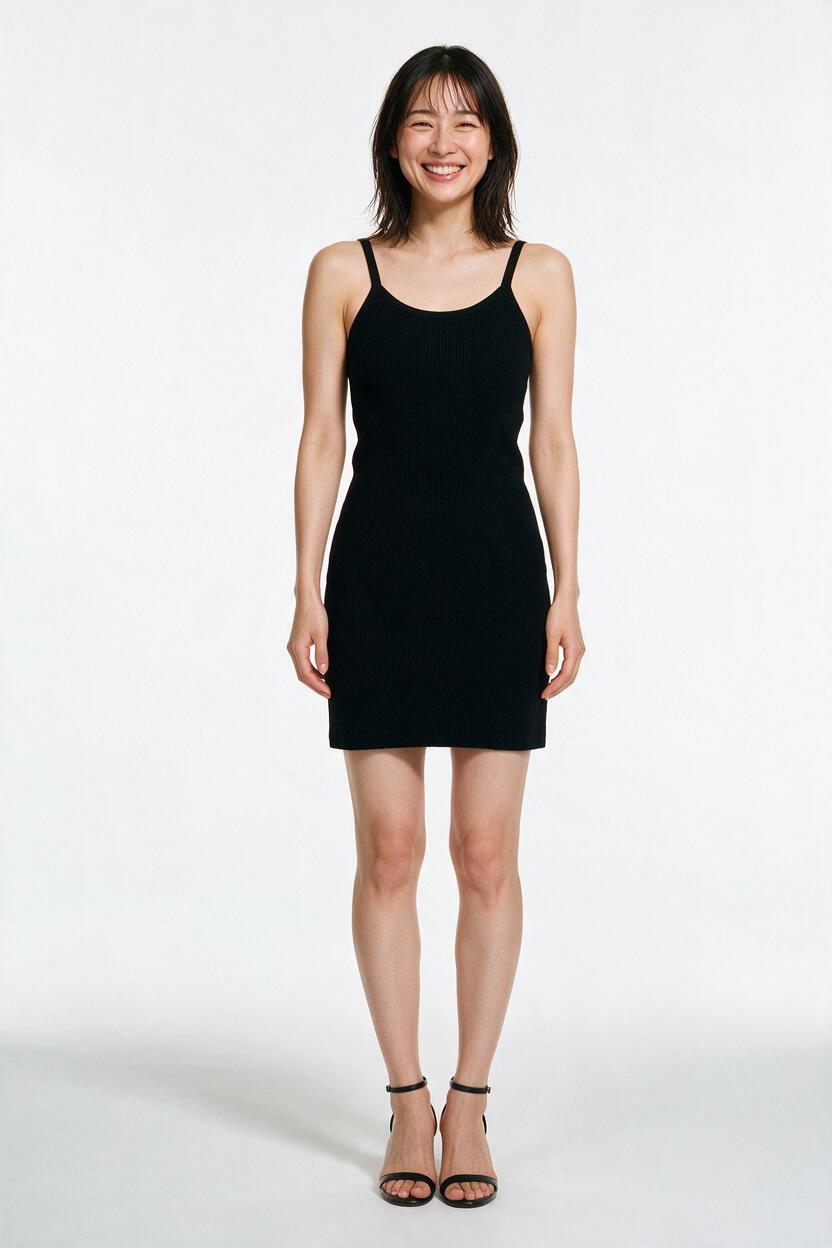
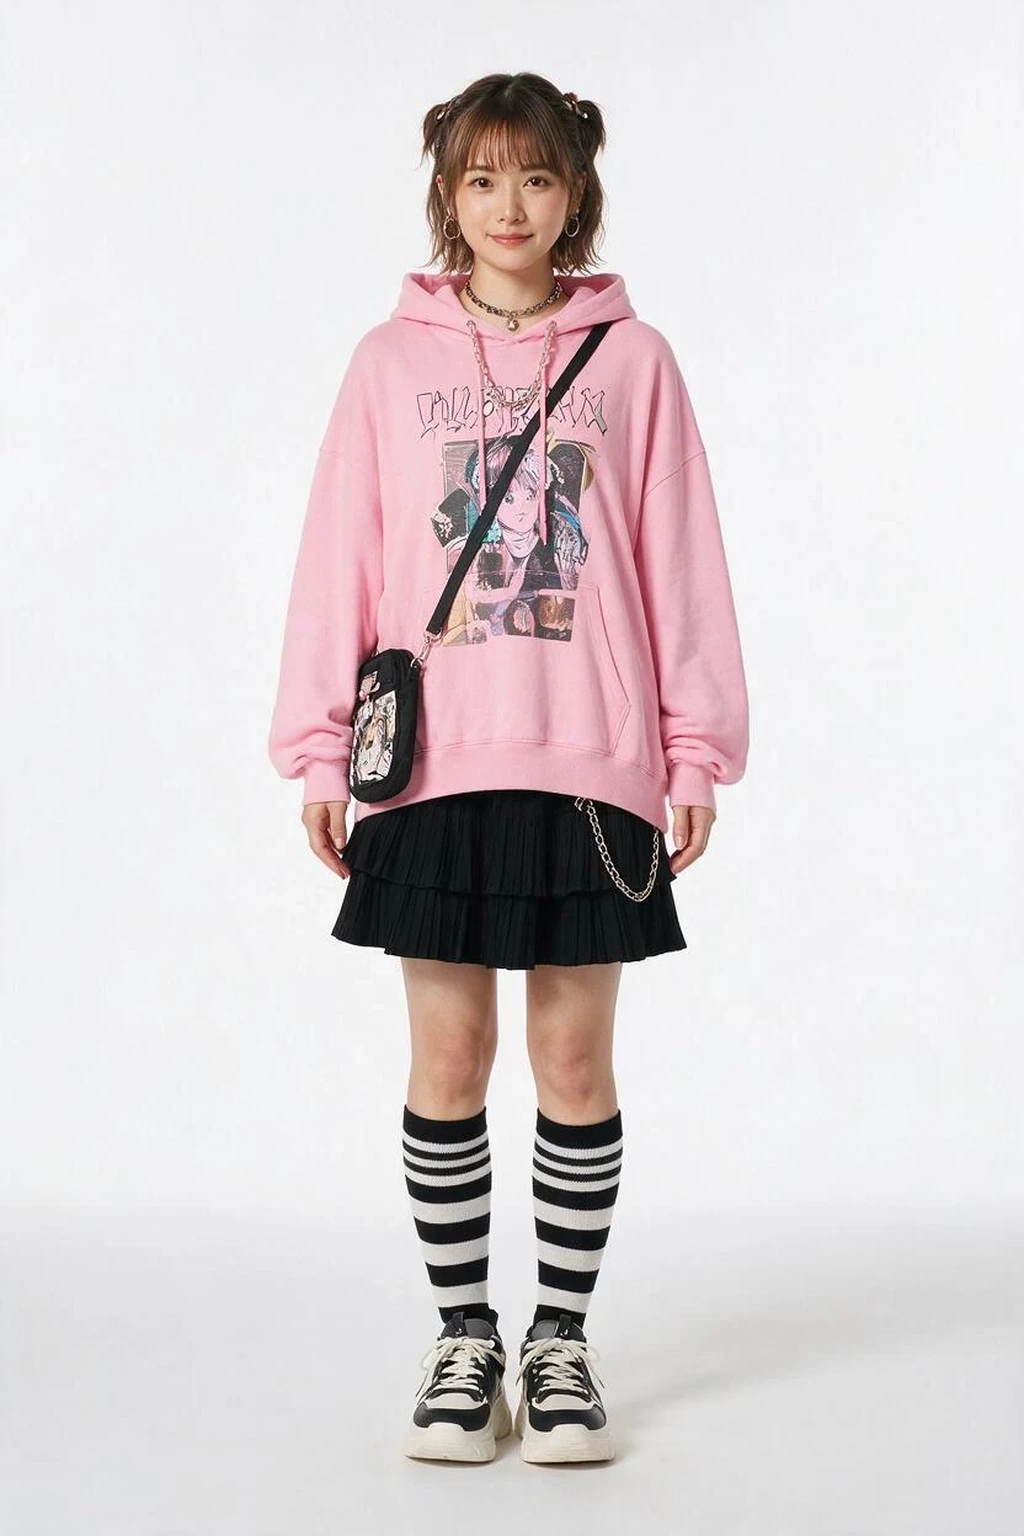
모델 참조는 인물을 기준으로 해야 합니다. 의상 참조는 지정한 의상만 기준으로 해야 합니다. 장면 참조는 사용하는 경우 환경과 조명을 기준으로 해야 합니다.
책임 사항을 적어 두세요. 이미지 모델에게 업로드 순서만으로 책임 사항을 추론하도록 요구하지 마세요.
프롬프트를 4개의 제어 계층으로 구성하세요.
1. 대상 의류의 이름을 쓰시오
"옷차림" 대신 "의상 역할"을 사용하세요. 저희 테스트에서는 목표 상의는 오버사이즈 연분홍색 그래픽 후드티였고, 목표 하의는 검은색 티어드 플리츠 미니스커트였습니다.
그 하나의 선택이 편집의 범위를 결정합니다.
2. 소스 모델을 보호하세요
모델 참조 이미지와 연결되어야 할 부분을 나열하세요: 정체성, 얼굴, 표정, 머리카락, 신체 비율, 포즈, 구도, 배경, 카메라, 조명, 그리고 보존하고 싶은 원본 소품 등.
저희는 기존의 검정색 스트랩 힐을 그대로 유지했습니다. 그 라인이 없었다면 신발 선택에 여전히 고민이 많았을 겁니다.
3. 이름으로 표시되는 추가 기능을 제외합니다.
“"액세서리 없음"이라는 표현은 눈에 보이는 목록보다 설득력이 떨어집니다. 가방, 목걸이, 초커, 스커트 체인, 줄무늬 양말, 플랫폼 스니커즈, 귀걸이, 그리고 땋은 머리 스타일까지 모두 목록에 포함시켰습니다.
이렇게 하면 각 항목이 검토 질문으로 바뀝니다. 가방은 없어졌나요? 양말은 없어졌나요? 원래 신던 하이힐은 그대로 있나요?
4. 신체 변형 없이 자연스러운 착용감을 설명하세요.
모델에게 옷이 자신의 몸에 맞도록 하라고 지시하고, 옷에 맞춰 몸을 바꾸지 말라고 하세요. 솔기, 주름, 드레이핑, 겹침, 그림자, 그리고 일정한 조명을 활용하도록 요청하세요.
이 AI 모델 체험 안내 메시지를 복사하세요
괄호 안의 항목을 바꾸고, 입력값과 관련 없는 줄은 모두 삭제하세요.
[프레임] AI 모델 착용 이미지 하나를 생성하세요. 모델: 이미지 1은 동일한 성인 인물의 얼굴, 머리카락, 신체 비율, 포즈, 프레임, 배경, 카메라 및 조명을 제어합니다. 의상: 이미지 2는 의상 정보만 제공합니다. 이미지 속 인물, 포즈, 머리카락, 프레임 또는 배경을 복사하지 마세요. 대상 상의: [의류, 색상, 소재, 디자인]. 대상 하의: [의류, 색상, 소재, 디자인]. 유지: [원래 신발, 액세서리 또는 기타 보이는 항목]. 제외: [의류 참조 이미지에 보이는 대상 외 레이어, 신발, 가방, 액세서리 등의 이름을 모두 나열하세요]. 핏: 사실적인 솔기, 주름, 드레이프, 겹침 및 그림자를 사용하여 의상을 기존 신체에 맞게 조정하세요. 의상에 맞추기 위해 신체를 변경하지 마세요. 요청하지 않은 레이어를 추가하지 마세요. 출력: [용도], [화면 비율], [반드시 표시해야 하는 영역], 워터마크 없음.우리는 동일한 입력값을 두 번 테스트했습니다.
이는 IMA Studio에서 진행된 통제된 테스트 결과이며, 모든 의상 조합이 동일하게 작동한다는 주장은 아닙니다. 두 결과 모두 동일한 소스 쌍, 동일한 전신 3:4 비율, 그리고 요청당 하나의 이미지를 사용했습니다.
모호한 요청
이미지 2의 의상을 이미지 1의 모델에게 입히세요. 첫 번째 모델은 그대로 두세요.원본 모델은 알아볼 수 있었지만, 후드티, 치마, 가방, 목걸이, 치마 체인, 줄무늬 양말, 플랫폼 스니커즈 등 주요 스타일링 요소는 모두 그대로 옮겨졌습니다. 지시사항에는 더 작은 목표물이 명시되어 있지 않았습니다.
통제된 요청
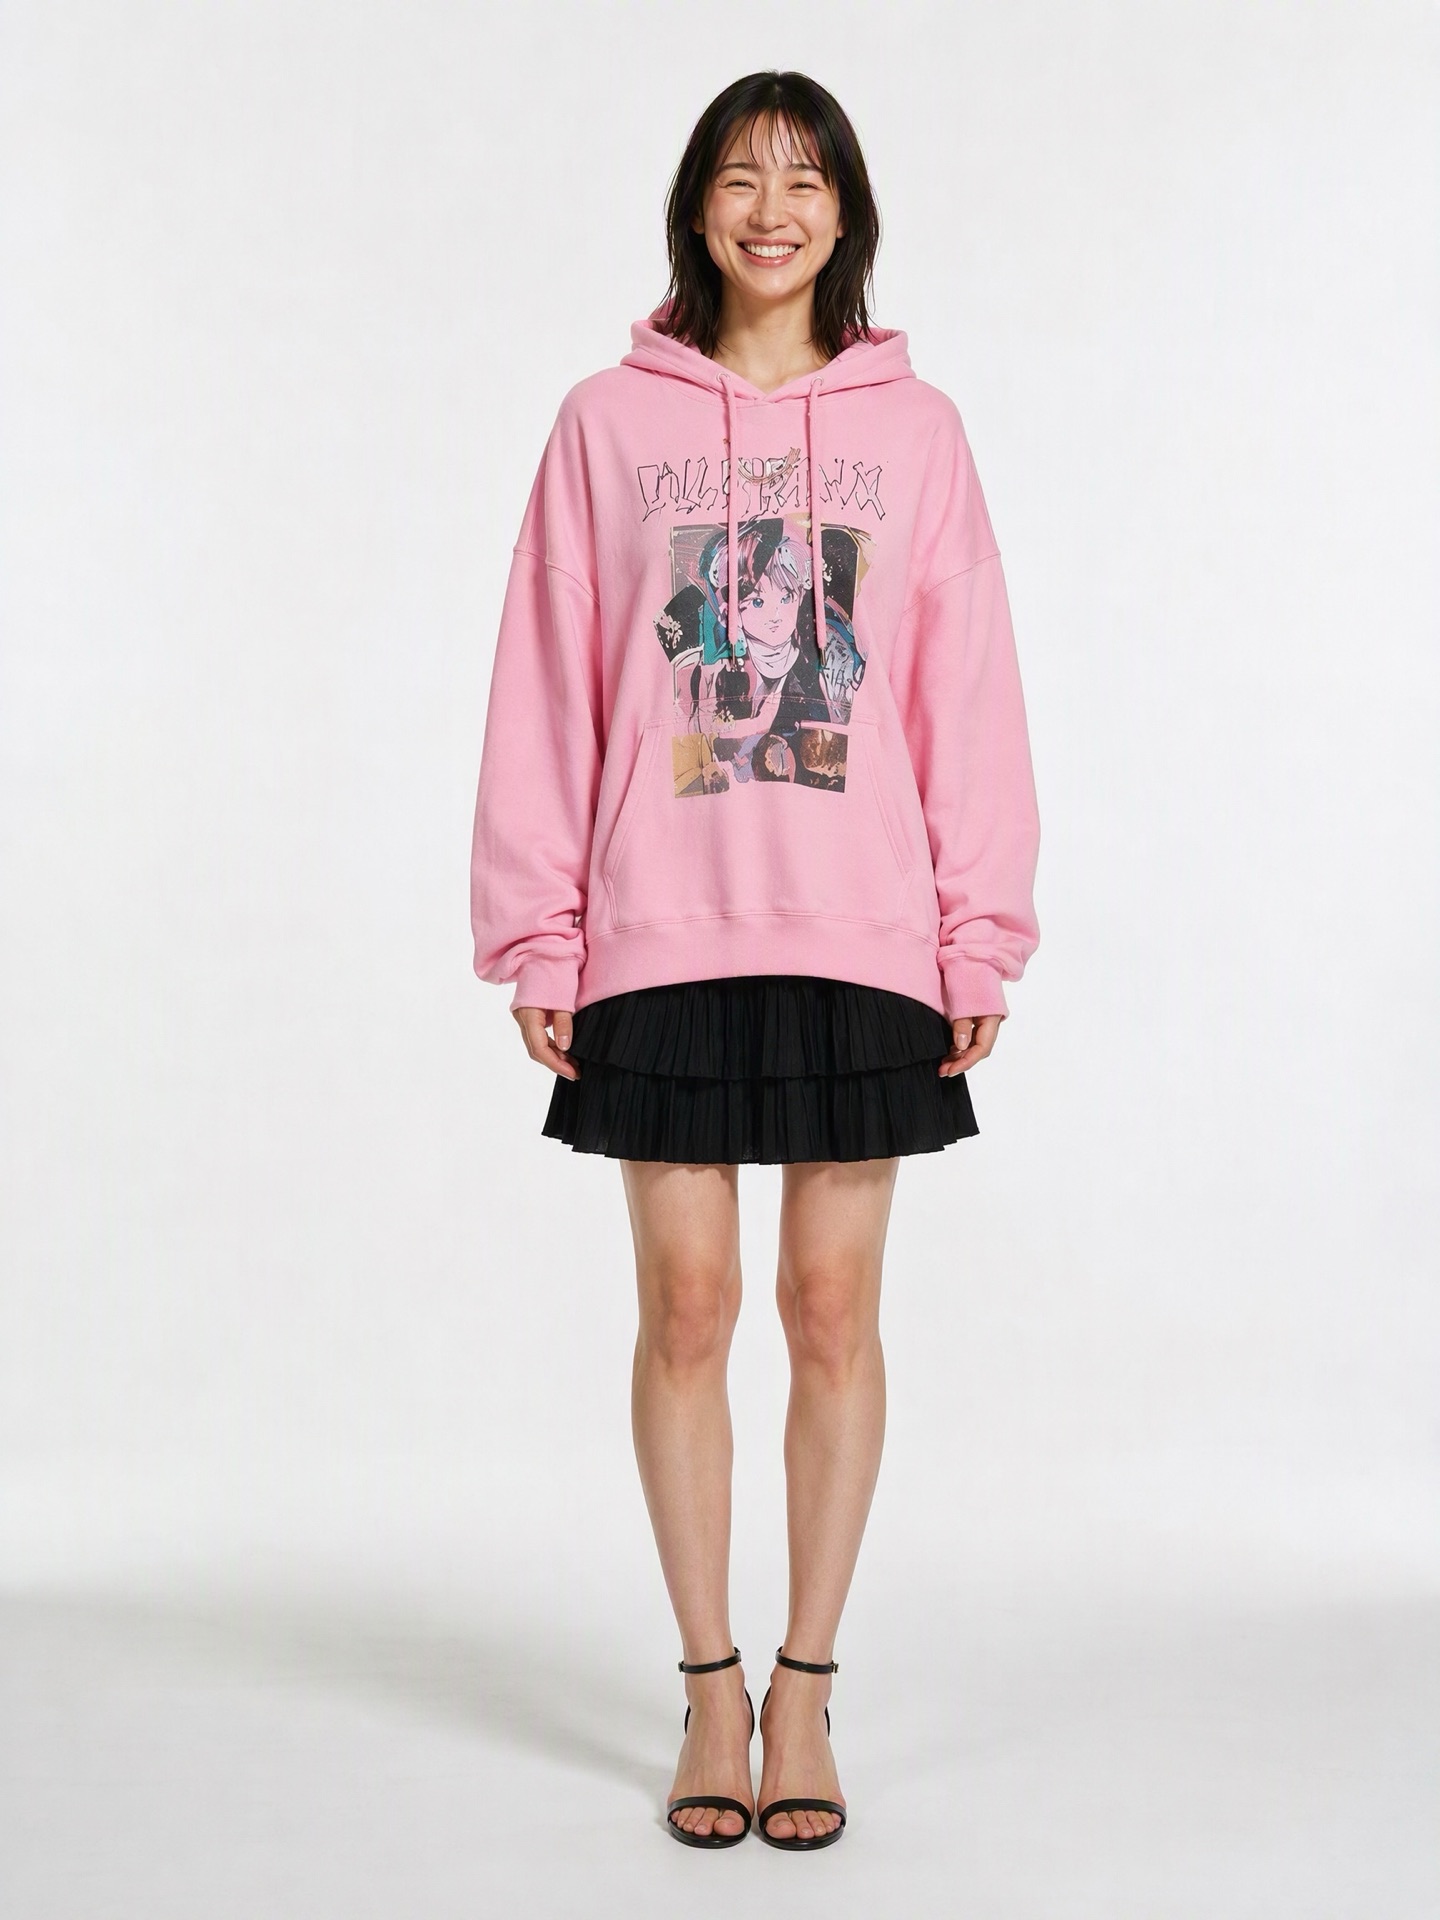
이미지 1은 모델 참고용입니다. 성인 인물, 얼굴, 미소, 머리카락, 신체 비율, 포즈, 흰색 스튜디오 배경, 조명, 검은색 스트랩 힐을 그대로 유지하세요. 이미지 2는 의상 참고용입니다. 이미지 속 인물, 머리카락, 포즈, 구도, 배경은 복사하지 마세요. 오버사이즈 연분홍색 그래픽 후드티와 검은색 티어드 플리츠 미니스커트만 옮겨 그리세요. 이미지 2의 가방, 목걸이, 초커, 스커트 체인, 줄무늬 양말, 플랫폼 스니커즈, 귀걸이, 땋은 머리 등 모든 액세서리는 제외하세요. 후드티와 스커트는 자연스럽게 몸에 맞게 그리세요. 옷에 맞추기 위해 몸매를 바꾸지 마세요.두 번째 결과에서는 원본 인물의 신원이 여전히 식별 가능했으며, 어깨 길이의 머리카락, 미소, 신체 비율, 정면 자세, 흰색 배경, 전신 구도, 검은색 스트랩 힐이 그대로 유지되었습니다. 후드티와 치마도 그대로 옮겨졌습니다. 명시된 대상 이외의 모든 항목은 사라졌습니다.
한 가지 아쉬운 점이 있다면, 너무 큰 후드티가 스커트의 상당 부분을 가린다는 것이었습니다. 검은색 티어드 디자인은 여전히 보였지만, 허리 부분을 확실히 보여줘야 하는 판매처라면 후드티 길이를 줄이거나, 앞부분을 안으로 넣어 입거나, 또는 디테일 컷을 따로 촬영해 달라고 요청해야 할 것입니다.
결과를 다음 순서대로 검토하세요.
- 대상 의류가 모두 있는지 확인하십시오.
- 명시된 모든 제외 항목을 확인하십시오. 단순히 "괜찮아 보인다"는 막연한 판단으로 이를 대체해서는 안 됩니다.
- 얼굴, 머리카락, 신체 비율, 자세 및 원본 소품을 모델 참고 자료와 비교하십시오.
- 의류의 가장자리, 소매, 허리띠, 밑단, 소매단, 그리고 겹치는 부분을 검사하십시오.
- 프레임이 구매자가 봐야 할 제품 영역을 잘 보여주는지 확인하십시오.
결과가 실패하면 실패한 규칙을 수정하세요. "크로스백과 줄무늬 양말은 벗고, 원래 신던 하이힐은 그대로 두세요"와 같이 구체적인 목표를 제시하면 다음 시도에 측정 가능한 목표가 생깁니다. "다시 시도하세요"는 그렇지 않습니다.
정확한 안내가 보장할 수 없는 것
구조화된 프롬프트는 모호성을 줄여줍니다. 하지만 그렇다고 해서 생성형 이미지 모델이 결정론적 의상 렌더링 엔진으로 바뀌는 것은 아닙니다.
작은 인쇄 디테일은 변경될 수 있습니다. 텍스트처럼 보이는 그래픽은 실제와 다소 차이가 날 수 있습니다. 원단의 무게와 드레이프성도 달라질 수 있습니다. 복잡한 겹침 부분은 재작업이 필요할 수 있습니다. 또한 AI 가상 착용 이미지는 실제 의류의 촉감, 신축성, 신체 치수에 따른 착용감을 소비자에게 알려줄 수 없습니다.
결과물을 검토가 필요한 시각적 자료로 활용하십시오. 신체 적합성 증거로 제시하지 마십시오.
자주 묻는 질문
전체 상품 소개에 모든 항목을 자세히 설명해야 할까요?
옮겨서는 안 되는 모든 대상 항목과 보이는 항목의 이름을 명시하십시오. 이미지 속 역할이 명확해지면 관련 없는 배경 세부 사항은 설명할 필요가 없습니다.
여러 이미지에 있는 의상들을 조합할 수 있나요?
네. 각 의복 역할을 소스에 연결하세요. 예를 들어, "상의는 이미지 2에서, 하의는 이미지 3에서 가져왔습니다."와 같이 지정합니다. 그런 다음 해당 참조에서 보이는 대상이 아닌 항목들을 나열하세요.
원래 포즈와 배경을 그대로 유지해야 할까요?
통제된 비교 및 일관된 전자상거래 데이터 세트를 위해 이미지를 보존하십시오. 새로운 포즈나 장면이 실제 최종 결과물에 포함될 때만 이미지를 변경할 수 있도록 하십시오.
프롬프트가 길수록 항상 더 좋을까요?
아니요. 유용한 프롬프트는 책임을 할당하고 제약 조건을 정의합니다. 형용사를 반복하는 것은 통제력을 더하지 않습니다.
다음 결과는 재시도가 아닌 수정이 되도록 하세요.
보다 예측 가능한 의류 범위는 제작 전에 확보할 수 있습니다. 각 참조에 작업을 할당하고, 원하는 의류의 이름을 지정하고, 일관성을 유지해야 하는 부품을 보호하고, 나타나지 않아야 하는 눈에 보이는 추가 요소를 목록으로 작성하십시오.
그 이점은 실용적입니다. 출력 결과가 빗나갈 경우, 어떤 규칙이 잘못되었는지 알 수 있습니다.
저자 소개