完整的造型参考可以将不需要的包包、珠宝、袜子和鞋子带入人工智能试穿系统。这项经过测试的提示功能可以区分目标服装、保留细节和明确排除的物品。.
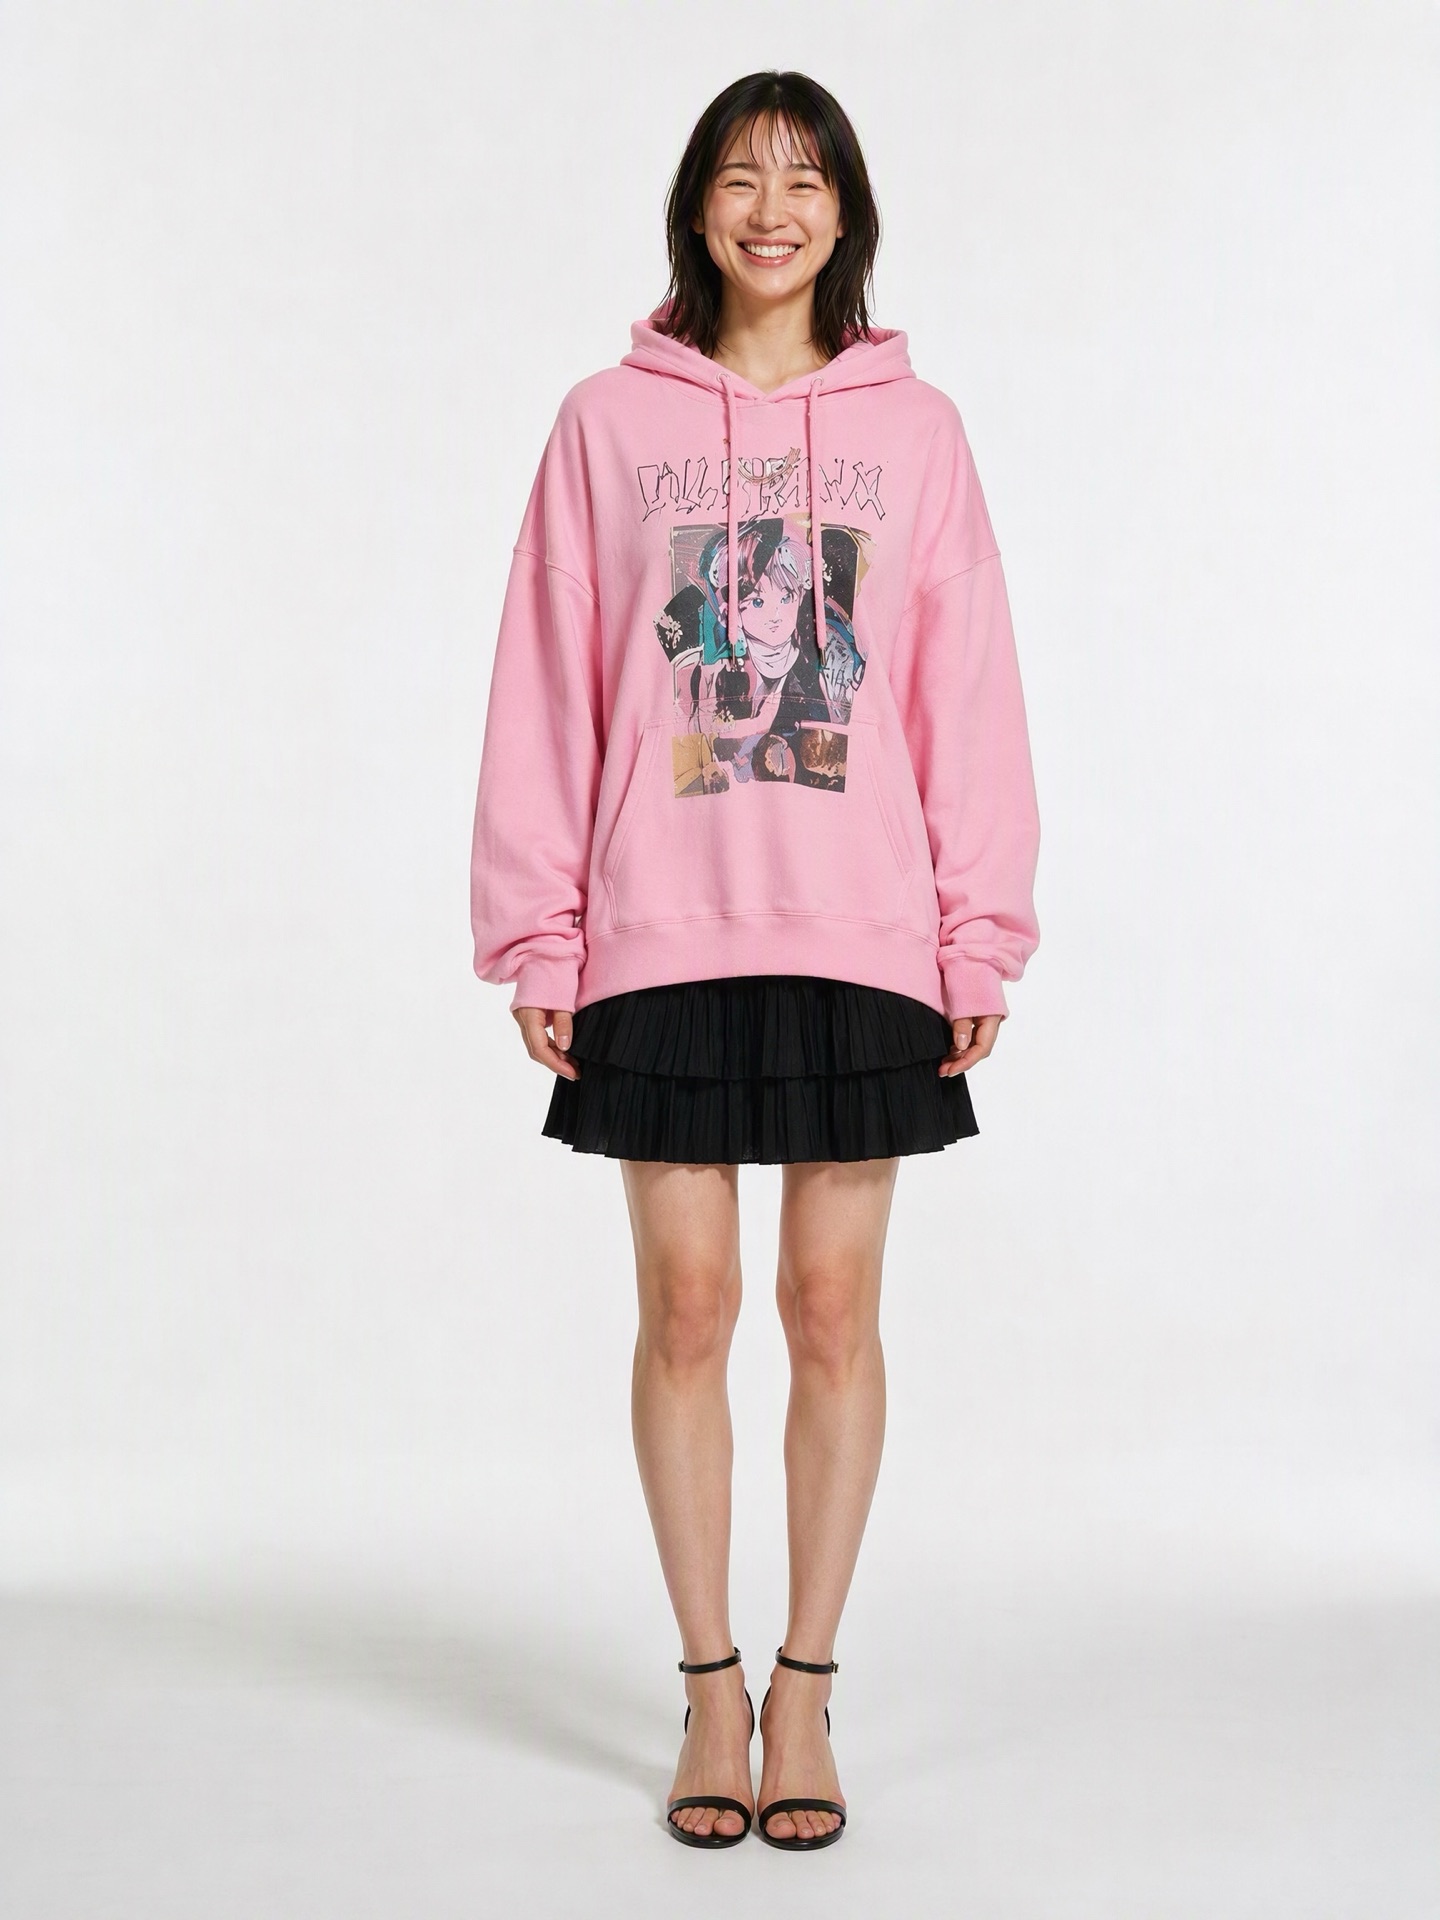
以下两张图片均出自同一张模特照片和同一套服装参考资料,仅说明文字有所不同。.
简答
为了控制哪些信息会导入到 AI 模型试穿图像中,请将请求分为四个层级:目标服装、参考图像角色、保留规则和排除项。模特照片负责识别身份和姿势。服装照片负责服装结构。标明所有可见的配饰或额外图层,确保它们不会被导入。.
为什么“把这套衣服穿在这个模特身上”这句话没有具体说明?
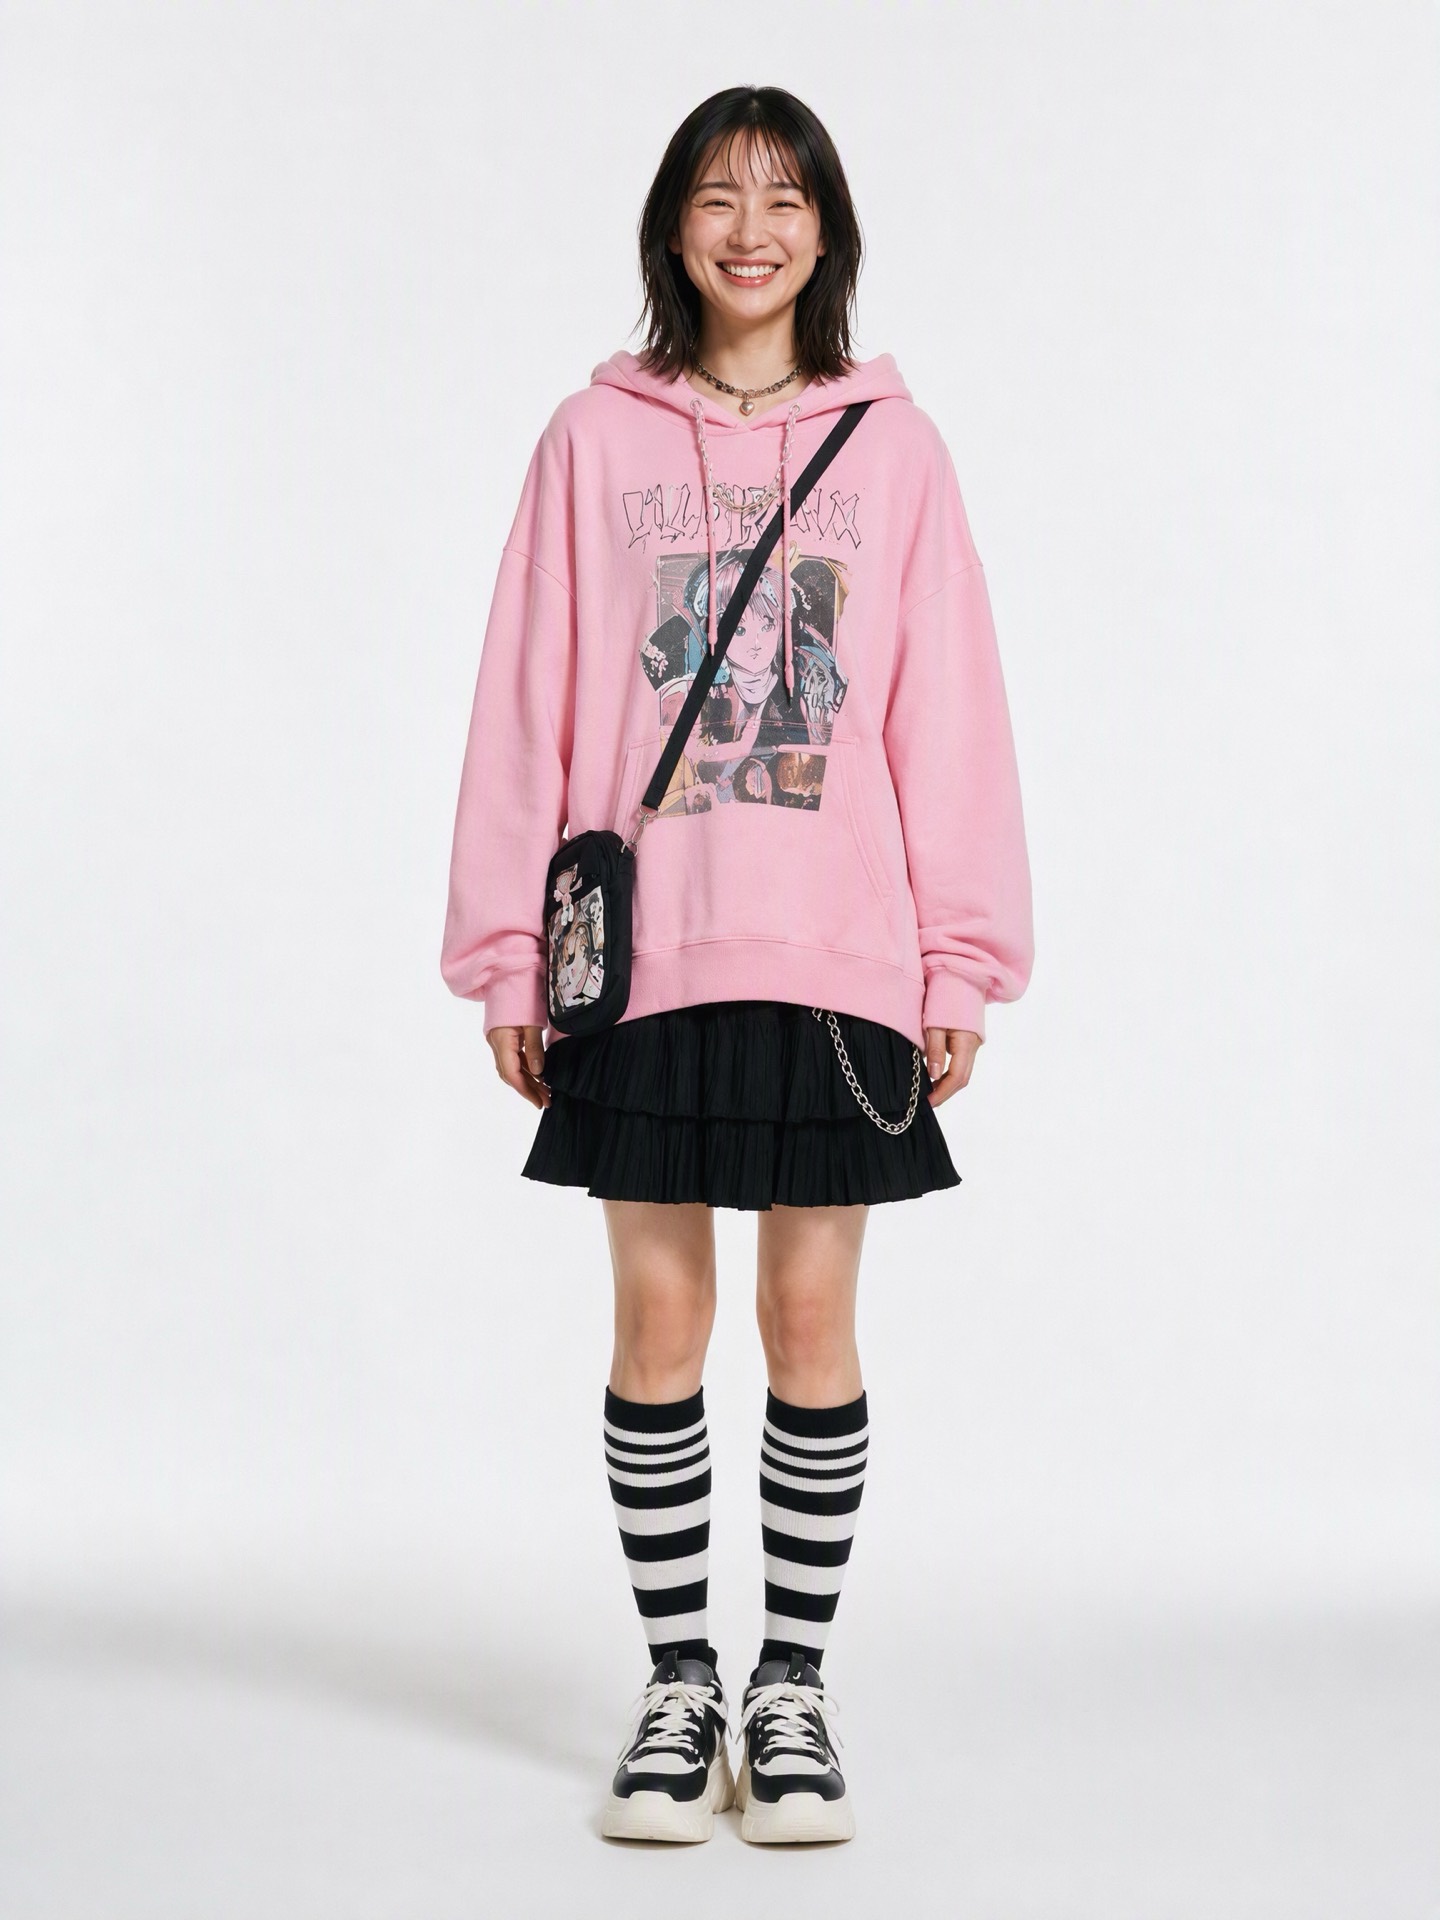
完整的造型参考包含很多选择。我们的服装图片包括一件粉色印花连帽衫、一条黑色层叠裙、一个斜挎包、叠戴项链、一条裙链、条纹袜、厚底运动鞋、耳环,以及不同的发型。.
简短的要求——“将图2中的服装穿到图1中的模特身上”——并没有说明哪些元素是关键。生成的结果复制了整套造型,视觉上很协调。但如果实际目标仅仅是连帽衫和裙子,那么这个结果就是错误的。.
这种区别至关重要。一张精美的图片仍然可能无法满足产品展示的要求。.
如果您是从平铺照片或挂架照片而不是完整效果图开始拍摄,请先参考我们更全面的工作流程。 利用服装照片创建AI模型试穿图像. 如果服装照片本身需要处理,请参阅如何操作。 拍摄没有模特的服装 生成之前。.
给每张参考图分配一项任务
这是两次测试中使用的两个输入参数。.
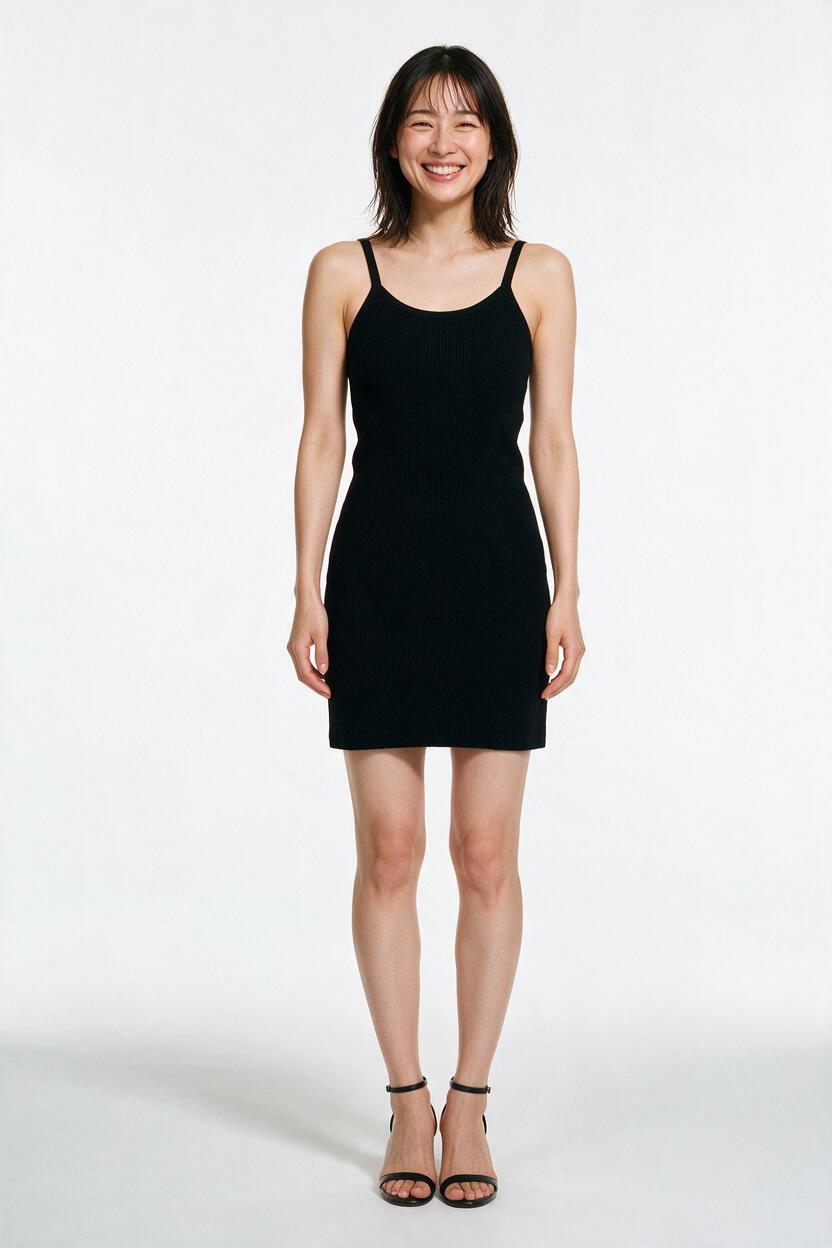
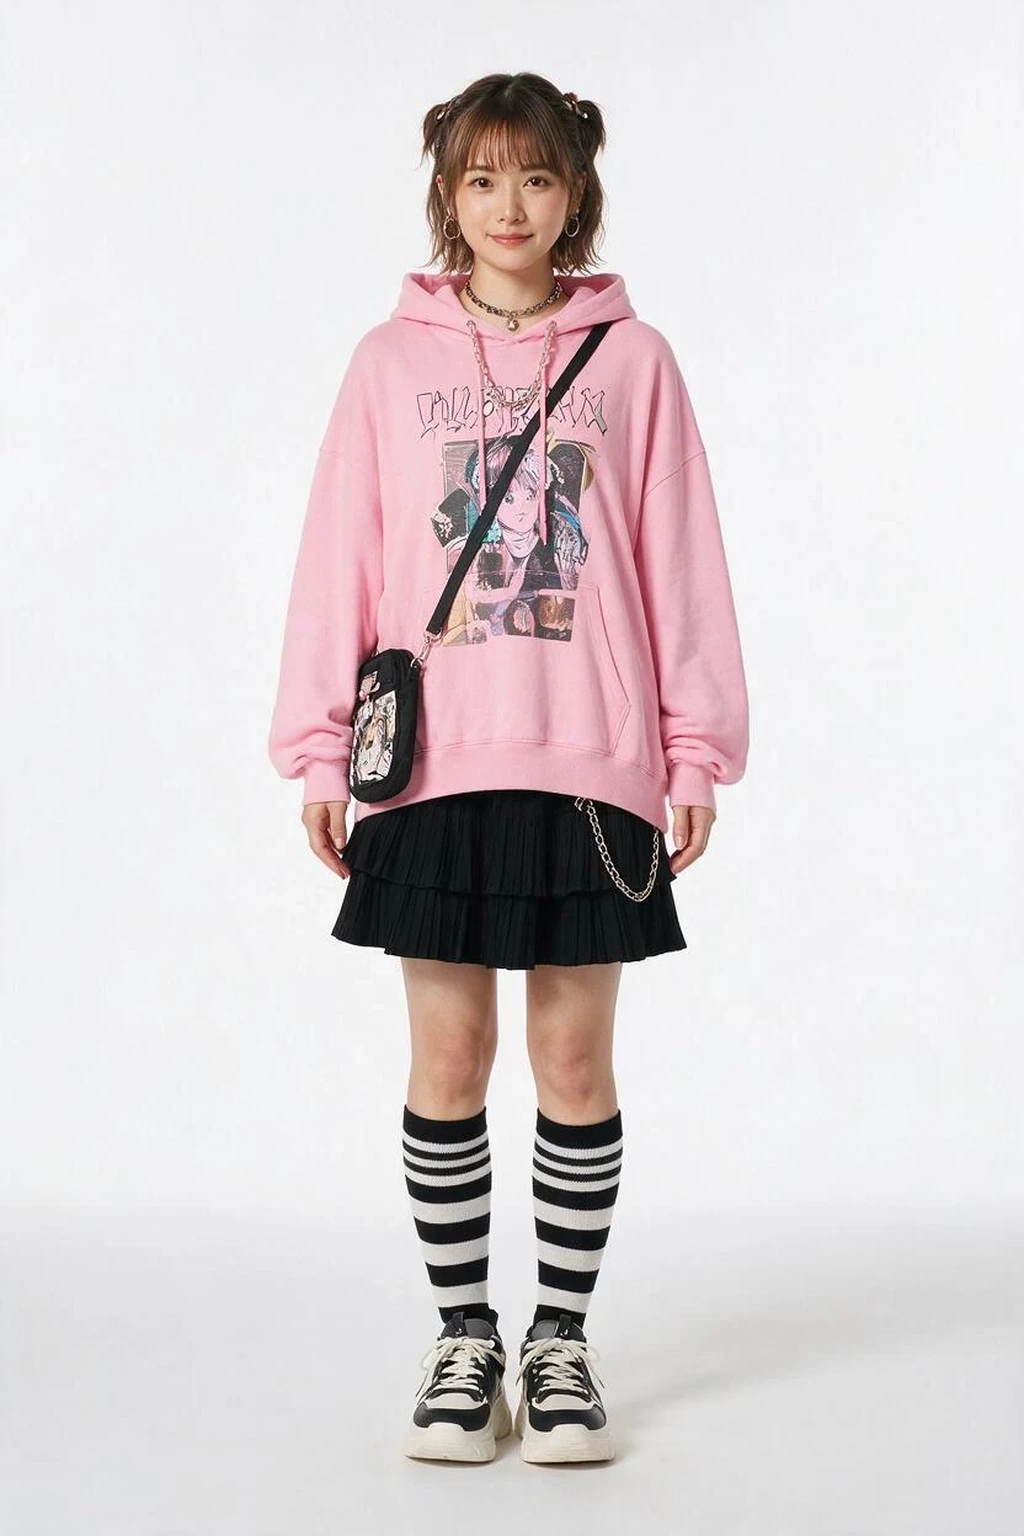
模型参考应该控制人物。服装参考应该只控制你指定的服装。场景参考(如果使用)应该控制环境和光照。.
把这些职责写下来。不要指望图像模型仅凭上传顺序就能推断出这些职责。.
构建提示符分为四个控制层
1. 列出目标服装的名称
使用服装角色而非“整套搭配”。在我们的测试中,目标上衣是浅粉色印花超大号连帽衫,目标下装是黑色多层百褶迷你裙。.
这一个选择就决定了编辑的范围。.
2. 保护源模型
列出应该与模型参考保持关联的部分:身份、面部、表情、头发、身体比例、姿势、构图、背景、相机、灯光,以及任何你想保留的原始物品。.
我们特意保留了原有的黑色细带高跟鞋。如果没有这条产品线,鞋履的选择仍然会是一个悬而未决的问题。.
3. 按名称排除可见的附加项
“没有配饰”的说法不如列出清单来得有力。我们列出了包包、项链、颈链、裙链、条纹袜、厚底运动鞋、耳环和双马尾发型。.
这样一来,每件物品就变成了一个复习问题。包不见了吗?袜子不见了吗?原来的鞋跟还在吗?
4. 描述无需改变体型即可自然贴合的穿着方式
告诉模特要根据模特的身材调整服装,而不是改变模特的身材去适应服装。要求模特展现服装的接缝、褶皱、垂坠感、重叠部分、阴影以及均匀的光线。.
复制此 AI 模型试用提示
替换括号内的内容,然后删除任何不适用于您的输入的行。.
创建一张[FRAING] AI模型试穿图像。模型:图像1控制同一成年人的面部、发型、身材比例、姿势、构图、背景、相机和光照。服装:图像2仅提供服装信息。请勿复制其人物、姿势、发型、构图或背景。目标上衣:[服装、颜色、材质、结构]。目标下装:[服装、颜色、材质、结构]。保留:[原有的鞋子、珠宝或其他可见物品]。排除:[列出服装参考图中所有非目标图层、鞋子、包包、珠宝和配饰的名称]。合身:使用逼真的接缝、褶皱、垂坠、重叠和接触阴影使服装适应现有身材。请勿为了适应服装而改变身材。请勿添加未经请求的图层。输出:[用途]、[宽高比]、[必须显示的区域],无水印。.我们对相同的输入进行了两次测试。
这是IMA Studio的一项受控测试,并非声称所有服装组合都会呈现相同的效果。两种输出均使用相同的源图像对、相同的3:4全身目标,且每次请求仅使用一张图片。.
含糊不清的请求
将图 2 中的服装穿到图 1 中的模特身上。保留第一个模特。.原模特的形象依然清晰可辨,但所有主要的造型元素都得以保留:连帽衫、裙子、包包、项链、裙链、条纹袜和厚底运动鞋。指导说明中没有定义更小的目标对象。.
受控请求
图1仅作为模特参考。请保留图中人物的面部特征、笑容、发型、身材比例、姿势、白色背景、灯光以及黑色细带高跟鞋。图2仅作为服装参考。请勿复制图中人物、发型、姿势、构图或背景。仅需复制图中浅粉色印花超大号连帽衫和黑色多层百褶迷你裙。请移除图2中的包包、项链、颈链、裙链、条纹袜、厚底运动鞋、耳环、双马尾辫以及所有其他配饰。连帽衫和裙子应自然合身。请勿为了适应服装而改变身材。.在第二个结果中,来源身份仍然清晰可辨,齐肩头发、微笑、身材比例、笔直的姿势、白色背景、全身构图以及黑色细带高跟鞋等特征均保持不变。连帽衫和裙子也保留了下来。所有提及的非目标物品均未出现。.
还有一个小小的不足之处:超大号的连帽衫遮住了裙子的大部分。虽然黑色的层叠裙摆仍然可见,但如果零售商需要清晰地看到腰带部分,应该要求缩短连帽衫的长度、将前片塞进裙子里,或者单独拍摄细节图。.
按此顺序查看结果
- 确认所有目标服装均已到位。.
- 逐条核查每一项排除条款。不要仅凭“看起来没问题”的笼统判断就草率行事。.
- 将脸部、头发、身体比例、姿势和原物与模特参考图进行比较。.
- 检查服装的边缘、袖口、腰带、下摆、袖子和重叠处。.
- 确认画面构图能够展现顾客需要看到的产品区域。.
如果结果不理想,就纠正出错的规则。“去掉斜挎包和条纹袜;保留原来的高跟鞋”为下一次尝试设定了一个可衡量的目标。“再试一次”则没有这个目标。.
精确的提示无法保证什么
结构化的提示可以减少歧义。它并不会将生成式图像模型变成确定性的服装渲染器。.
印刷细节可能会有所变化。类似文字的图案可能会变得模糊不清。面料的重量和垂坠感可能会改变。复杂的重叠部分可能需要重新调整。而且,人工智能生成的试穿图像无法告诉顾客实物服装的触感、弹性和合身程度。.
将输出结果用作仍需审核的视觉内容,切勿将其作为体检合格证明。.
常见问题解答
我是否需要在完整的产品介绍中描述每一件产品?
请列出所有目标物品和所有不得转移的可见物品。一旦图像角色明确,就无需赘述无关的背景细节。.
我可以把几张图片里的服装搭配在一起吗?
是的。将每件服装的角色绑定到一个来源:“上衣来自图 2;裤子来自图 3。”然后列出这些参考资料中可见的非目标物品。.
我应该保留原有的姿势和背景吗?
保留这些图片,以便进行可控对比和确保电商产品图片的一致性。只有当新的姿势或场景是实际交付内容的一部分时,才允许更改这些图片。.
提示信息越长越好吗?
不。有效的提示能够明确责任并界定限制。重复形容词并不能增加控制力。.
下次结果应该作为修正,而不是再次重掷。
更可预测的服装范围始于生成之前。为每个参考项分配一个任务,命名所需的服装,保护应保持一致的部件,并列出不应出现的可见额外部件。.
这样做的好处是实际的:如果输出结果不理想,你就知道是哪条规则失败了。.
关于作者