完整的造型參考可以將不需要的包包、珠寶、襪子和鞋子帶入人工智慧試穿系統。這項經過測試的提示功能可以區分目標服裝、保留細節和明確排除的物品。.
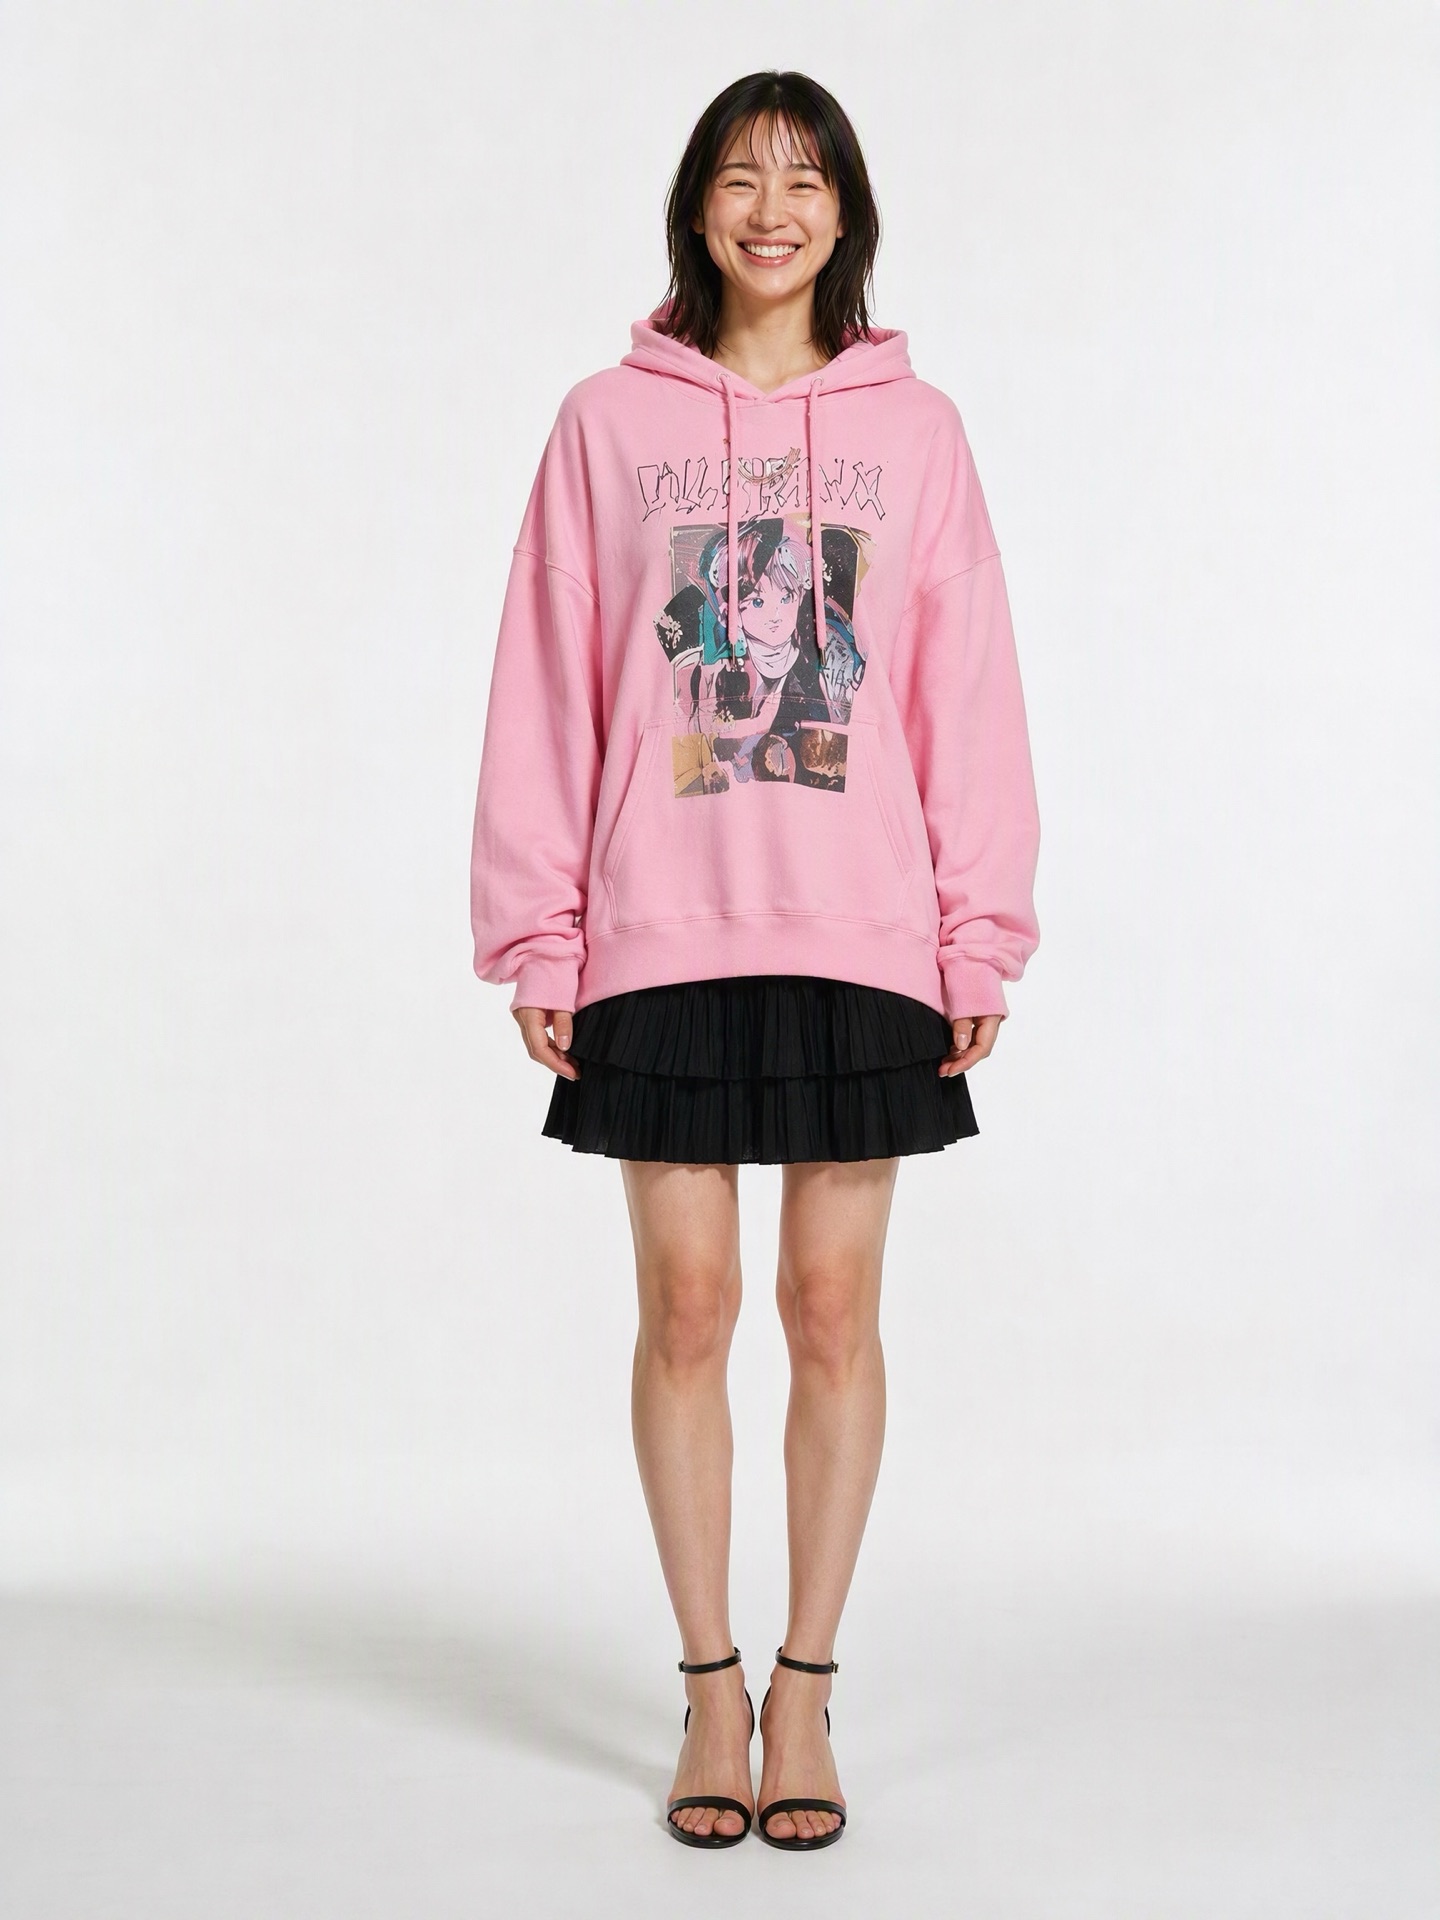
以下兩張圖片皆出自同一張模特兒照片和同一套服裝參考資料,僅說明文字有所不同。.
簡答
為了控制哪些資訊會匯入 AI 模型試穿影像中,請將要求分為四個層級:目標服裝、參考影像角色、保留規則和排除項。模特兒照片負責辨識身分和姿勢。服裝照片負責服裝結構。標明所有可見的配件或額外圖層,確保它們不會被匯入。.
為什麼「把這套衣服穿在這個模特兒身上」這句話沒有具體說明?
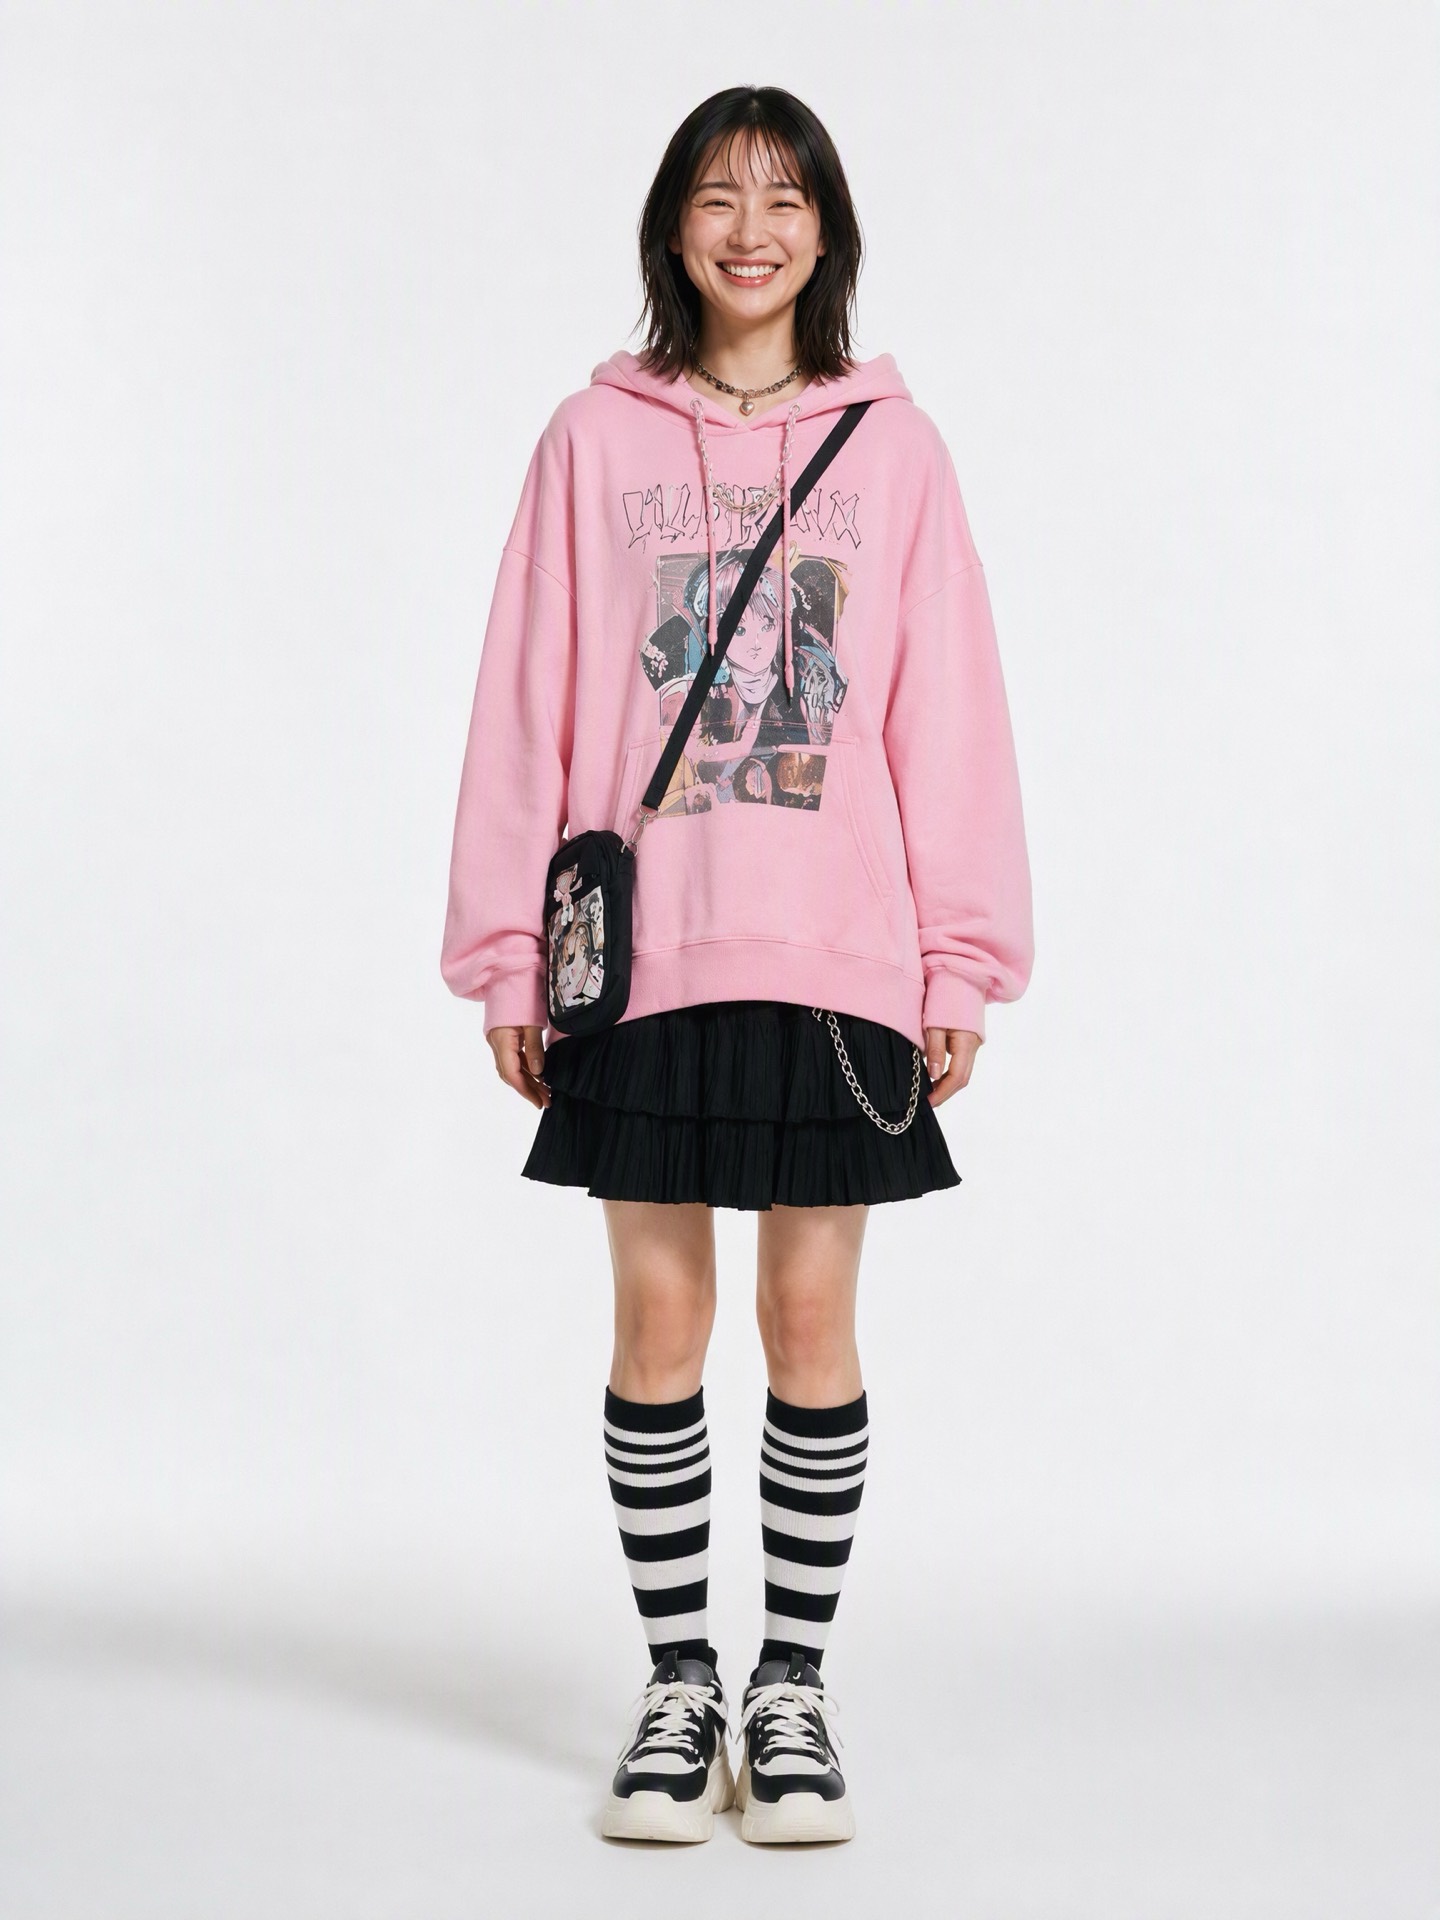
完整的造型參考包含許多選擇。我們的服裝圖片包括一件粉紅色印花連帽衫、一條黑色層疊裙、一個斜背包、疊戴項鍊、一條裙鏈、條紋襪、厚底運動鞋、耳環,以及不同的髮型。.
簡短的要求——「將圖2的服裝穿到圖1的模特兒身上」——並沒有說明哪些元素是關鍵。產生的結果複製了整套造型,視覺上很協調。但如果實際目標只是連帽衫和裙子,那麼這個結果就是錯的。.
這種區別至關重要。一張精美的圖片仍然可能無法滿足產品展示的要求。.
如果您是從平鋪照片或掛架照片而不是完整效果圖開始拍攝,請先參考我們更全面的工作流程。 利用服裝照片創建AI模型試穿圖像. 如果服裝照片本身需要處理,請參閱如何操作。 拍攝沒有模特兒的服裝 生成之前。.
為每張參考圖分配一項任務
這是兩次測試中使用的兩個輸入參數。.
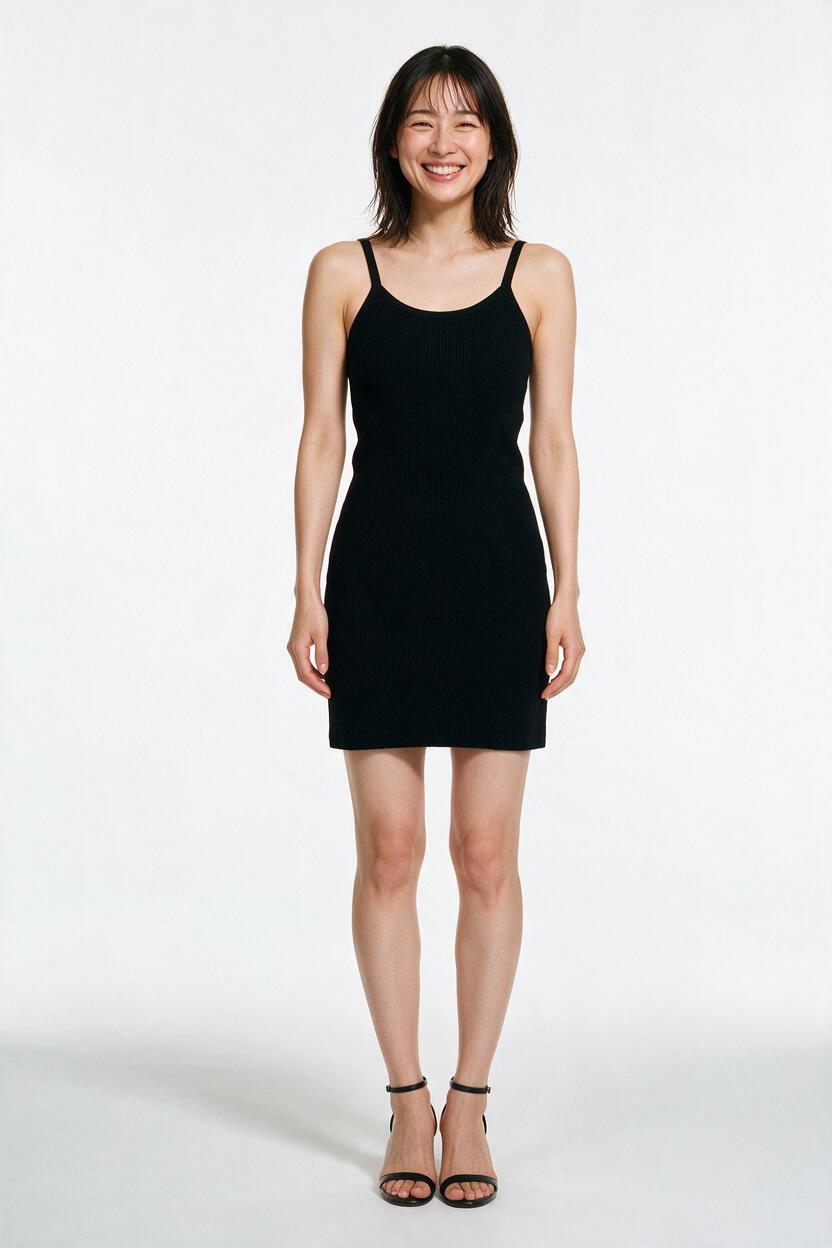
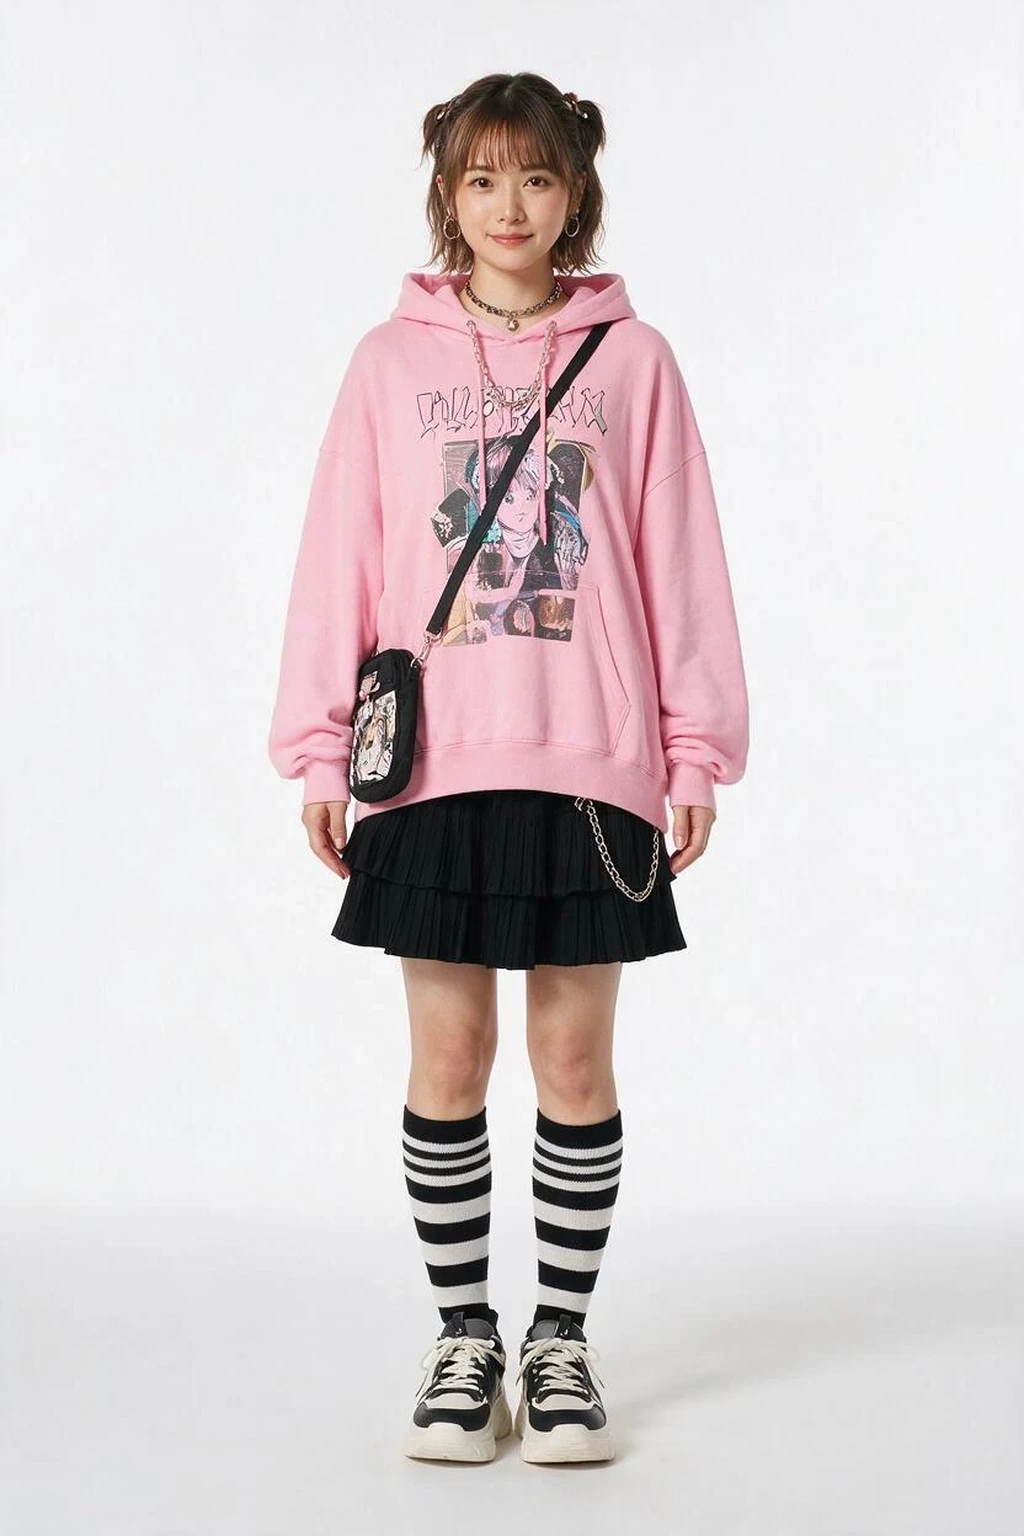
模型參考應該控制人物。服裝參考應該只控制你指定的服裝。場景參考(如果使用)應該控制環境和光照。.
把這些職責寫下來。不要指望圖像模型僅憑上傳順序就能推斷出這些職責。.
建構提示符號分為四個控制層
1. 列出目標服裝的名稱
使用服裝角色而非「整套搭配」。在我們的測試中,目標上衣是淺粉紅色印花超大號連帽衫,目標下裝是黑色多層百褶迷你裙。.
這一個選擇就決定了編輯的範圍。.
2. 保護源模型
列出應該與模型參考保持關聯的部分:身分、臉部、表情、頭髮、身體比例、姿勢、構圖、背景、相機、燈光,以及任何你想保留的原始物品。.
我們特意保留了原有的黑色細帶高跟鞋。如果沒有這條產品線,鞋履的選擇仍然會是個懸而未決的問題。.
3. 依名稱排除可見的附加項
“「沒有配件」的說法不如列出清單來得有力。我們列出了包包、項鍊、頸鍊、裙鍊、條紋襪、厚底運動鞋、耳環和雙馬尾髮型。.
這樣一來,每件物品就變成了複習問題。包包不見了嗎?襪子不見了嗎?原來的鞋跟還在嗎?
4. 描述無需改變體型即可自然貼合的穿著方式
告訴模特兒要根據模特兒的身材調整服裝,而不是改變模特兒的身材去適應服裝。請模特兒展現服裝的接縫、褶皺、垂墜感、重疊部分、陰影以及均勻的光線。.
複製此 AI 模型試用提示
替換括號內的內容,然後刪除任何不適用於您的輸入的行。.
創建一張[FRAING] AI模型試穿圖像。模型:影像1控制同一成年人的臉部、髮型、身材比例、姿勢、構圖、背景、相機和光線。服裝:圖像2僅提供服裝資訊。請勿複製其人物、姿勢、髮型、構圖或背景。目標上衣:[服裝、顏色、材質、結構]。目標下裝:[服裝、顏色、材質、結構]。保留:[原有的鞋子、珠寶或其他可見物品]。排除:[列出服裝參考圖中所有非目標圖層、鞋子、包包、珠寶和配件的名稱]。合身:使用逼真的接縫、褶皺、垂墜、重疊和接觸陰影使服裝適應現有身材。請勿為了適應服裝而改變身材。請勿新增未經請求的圖層。輸出:[用途]、[寬高比]、[必須顯示的區域],無浮水印。.我們對相同的輸入進行了兩次測試。
這是IMA Studio的一項受控測試,並非聲稱所有服裝組合都會呈現相同的效果。兩種輸出均使用相同的來源影像對、相同的3:4全身目標,且每次請求僅使用一張圖片。.
含糊不清的請求
將圖 2 的服裝穿到圖 1 的模特兒身上。保留第一個模特兒。.原模特兒的形象依然清晰可辨,但所有主要的造型元素都得以保留:連帽衫、裙子、包包、項鍊、裙鏈、條紋襪和厚底運動鞋。指導說明中沒有定義較小的目標物。.
受控請求
圖1僅作為模特兒參考。請保留圖中人物的臉部特徵、笑容、髮型、身材比例、姿勢、白色背景、燈光以及黑色細帶高跟鞋。圖2僅作為服裝參考。請勿複製圖中人物、髮型、姿勢、構圖或背景。僅需複製圖中淺粉色印花超大號連帽衫和黑色多層百褶迷你裙。請移除圖2的包包、項鍊、頸鍊、裙鍊、條紋襪、厚底運動鞋、耳環、雙馬尾辮以及所有其他配件。連帽衫和裙子應自然合身。請勿為了適應服裝而改變身材。.在第二個結果中,來源身份仍然清晰可辨,齊肩頭髮、微笑、身材比例、筆直的姿勢、白色背景、全身構圖以及黑色細帶高跟鞋等特徵均保持不變。連帽衫和裙子也保留了下來。所有提及的非目標物品均未出現。.
還有一個小小的缺點:超大號的連帽衫遮住了裙子的大部分。雖然黑色的層疊裙擺仍然可見,但如果零售商需要清楚地看到腰帶部分,應該要求縮短連帽衫的長度、將前片塞進裙子裡,或者單獨拍攝細節圖。.
按此順序查看結果
- 確認所有目標服裝均已到位。.
- 逐條核查每項排除條款。不要僅憑「看起來沒問題」的籠統判斷就草率行事。.
- 將臉部、頭髮、身體比例、姿勢和原物與模特兒參考圖進行比較。.
- 檢查服裝的邊緣、袖口、腰帶、下擺、袖子和重疊處。.
- 確認畫面構圖能夠展現顧客需要看到的產品區域。.
如果結果不理想,就修正出錯的規則。 「去掉斜背包和條紋襪;保留原來的高跟鞋」為下一次嘗試設定了一個可衡量的目標。 「再試一次」則沒有這個目標。.
精確的提示無法保證什麼
結構化的提示可以減少歧義。它並不會將生成式影像模型變成確定性的服裝渲染器。.
印刷細節可能會有所變化。類似文字的圖案可能會變得模糊不清。布料的重量和垂墜感可能會改變。複雜的重疊部分可能需要重新調整。而且,人工智慧生成的試穿圖像無法告訴顧客實體服裝的觸感、彈性和合身程度。.
將輸出結果用作仍需審核的視覺內容,切勿將其作為體檢合格證明。.
常見問題解答
我是否需要在完整的產品介紹中描述每一件產品?
請列出所有目標物品和所有不得轉移的可見物品。一旦影像角色明確,就無需贅述無關的背景細節。.
我可以把幾張圖片裡的服裝搭配在一起嗎?
是的。將每件服裝的角色綁定到一個來源:「上衣來自圖 2;褲子來自圖 3。」然後列出這些參考資料中可見的非目標物品。.
我應該保留原有的姿勢和背景嗎?
保留這些圖片,以便進行可控對比和確保電商產品圖片的一致性。只有當新的姿勢或場景是實際交付內容的一部分時,才允許更改這些圖片。.
提示訊息越長越好嗎?
不。有效的提示能夠明確責任並界定限制。重複形容詞並不能增加控制。.
下次結果應該作為修正,而不是再次重擲。
更可預測的服裝範圍始於生成之前。為每個參考項分配一個任務,命名所需的服裝,保護應保持一致的部件,並列出不應出現的可見額外部件。.
這樣做的好處是實際的:如果輸出結果不理想,你就知道哪一條規則失敗了。.
作者簡介